본문으로 건너뛰기

PAN++

· 약 19분
eunsung shin
Software Engineer

이번 글은 2021년 8월에 나온 PAN++: Towards Efficient and Accurate End-to-End Spotting of Arbitrarily-Shaped Text의 리뷰이다. 텍스트 탐지(STD)와 텍스트 인식(STR)이 한 번에 이루어지는 End2End Text Spotting 모델이고, 기존의 End2End 모델들이나 STD(only) 모델들과 비교했을 때, 더 빠른 속도와 정확도를 갖는다고 한다. End2End Spotting 모델이긴 하지만, 이 글에서는 텍스트 탐지 과정이 어떻게 이루어지는지에 대해서만 중점적으로 다룰 예정이다.
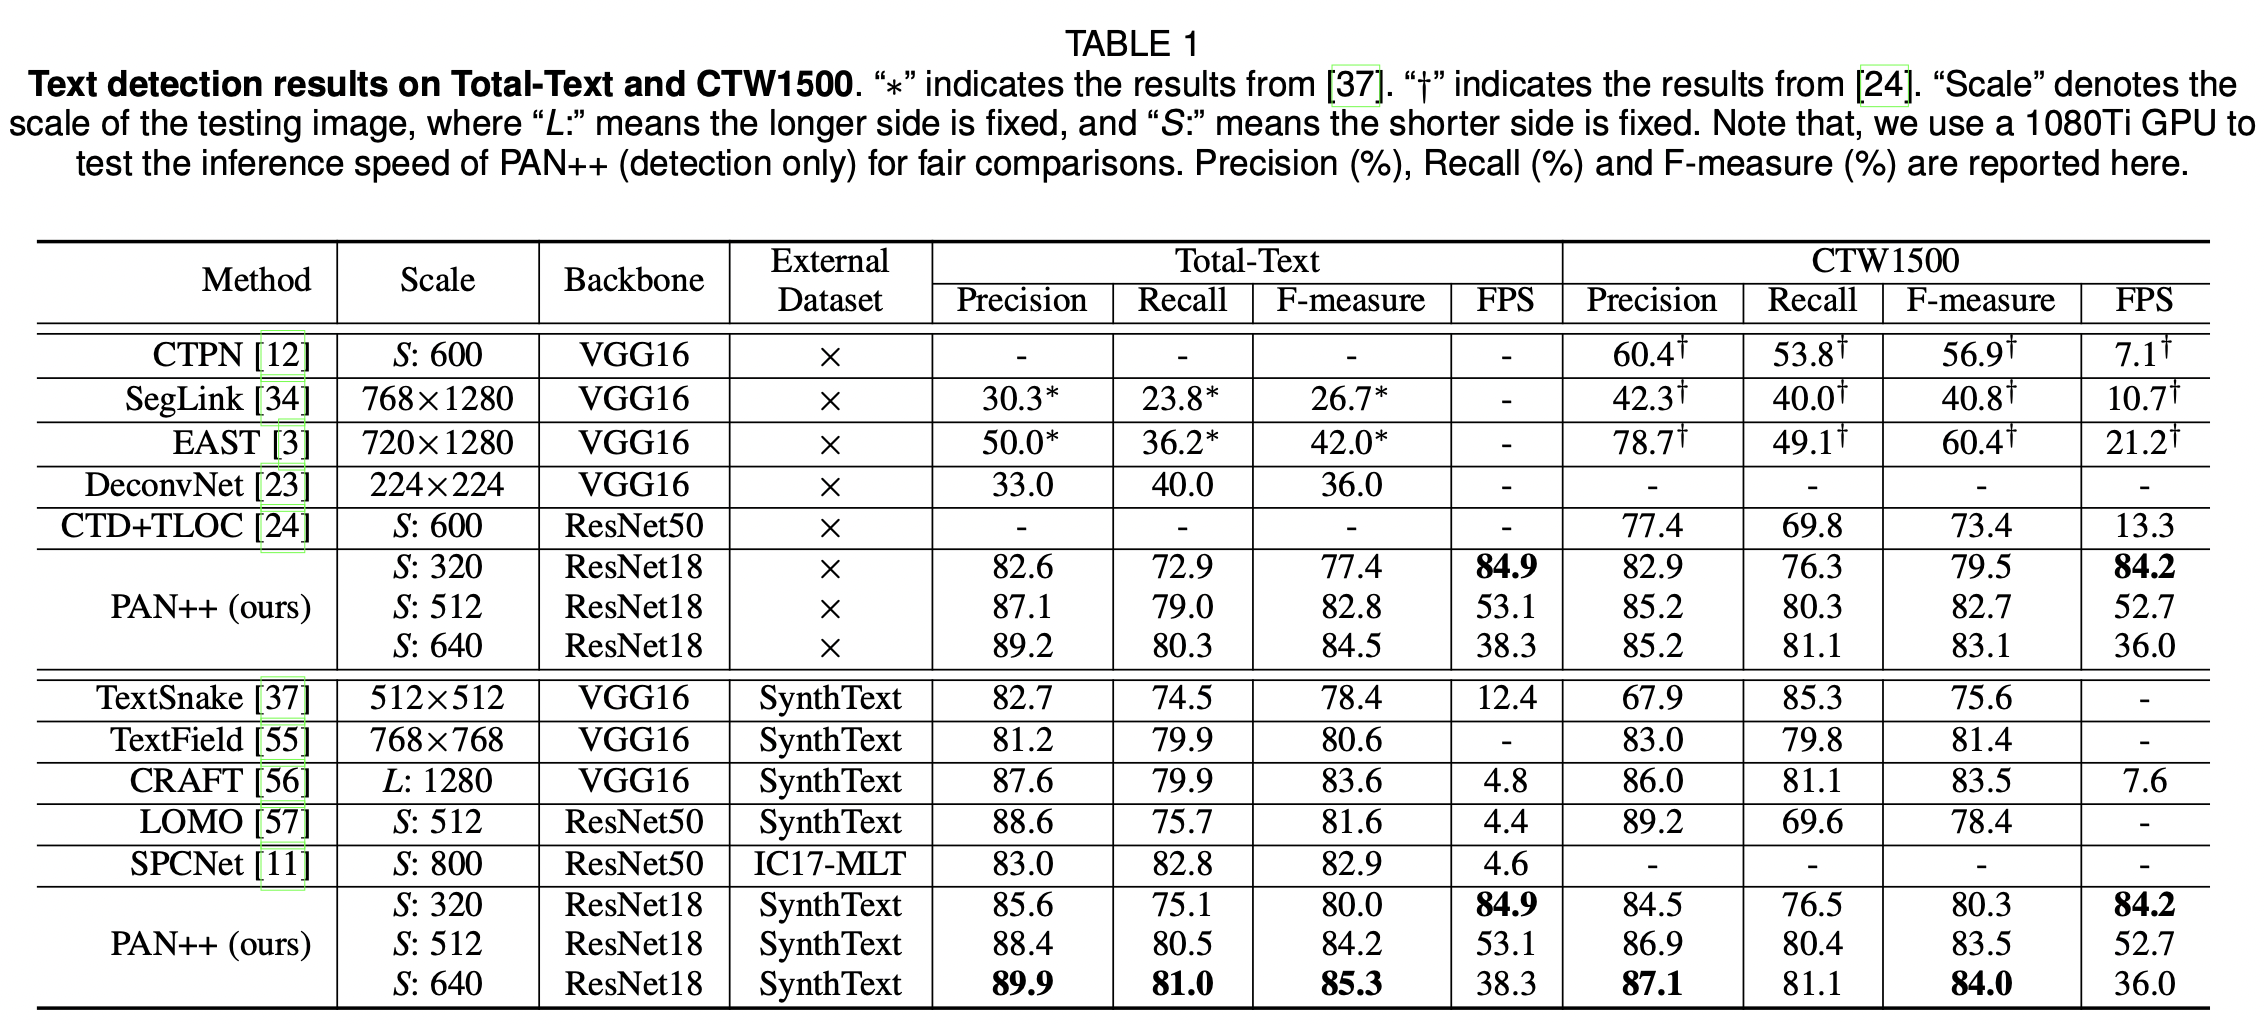
PAN++와 기존 STD 모델 간의 Precision, Recall, F1 Measure 비교
PAN++와 기존 STD 모델 간의 Precision, Recall, F1 Measure 비교

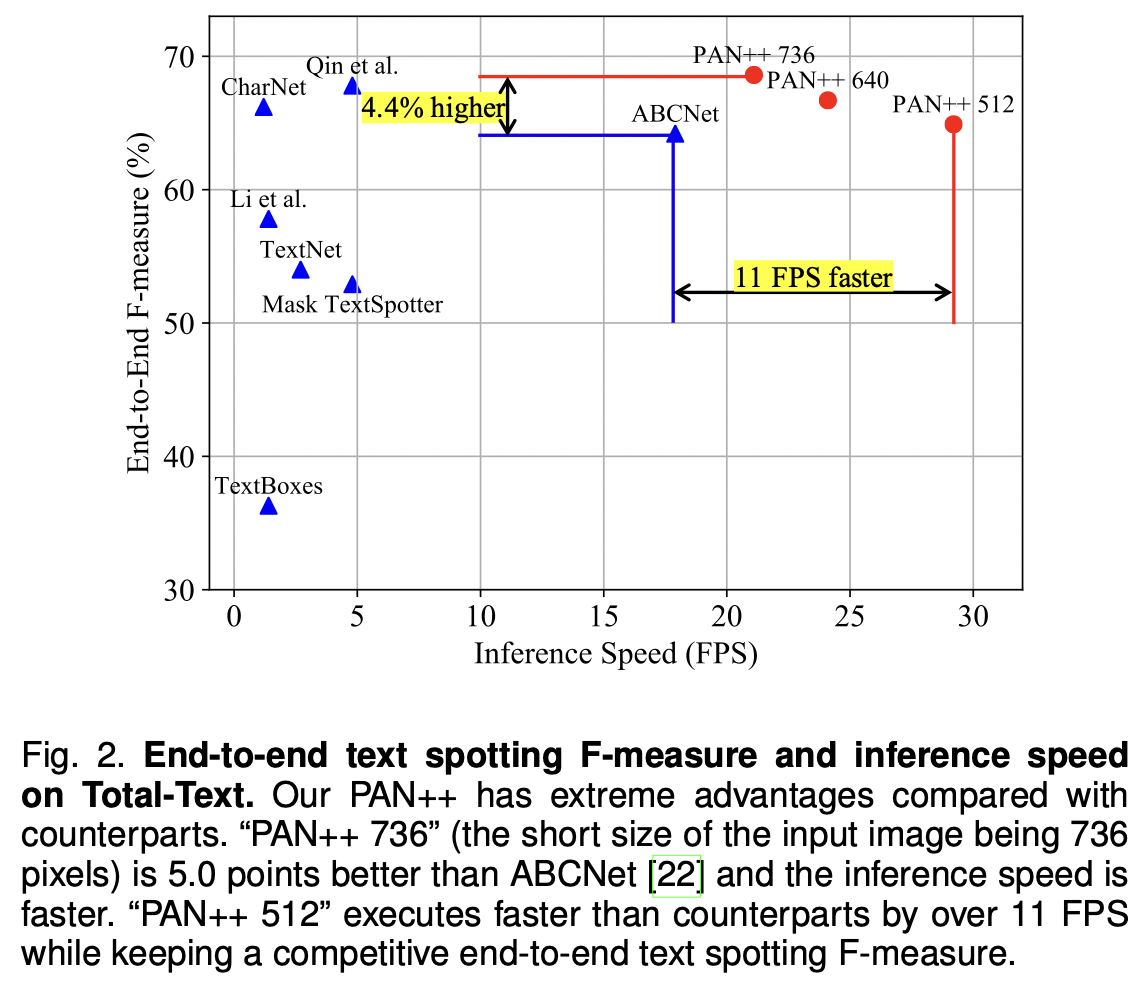
PAN++와 기존 End2End text spotting 모델 간의 F-measure와 Inference Speed 비교

PAN++와 기존 End2End text spotting 모델 간의 F-measure와 Inference Speed 비교

PAN++ 모델의 탄생 배경​

텍스트 탐지가 어려운 이유는 탐지해야하는 텍스트의 형태가 매번 다르기 때문이다. 빳빳한 A4용지 위에 또렷하게 프린트된 텍스트는 탐지가 쉬운 반면, 종이가 구겨져있다거나, 잉크가 흐릿하다거나, 아니면 글자가 일직선이 아닌 다른 형태(폴리곤)로 적혀져있거나 하는 예외케이스들이 존재하기 때문이다.

텍스트 탐지 방법은 크게 1)예측값을 텍스트 탐지 박스 좌표로 잡는 regression-based와 2)텍스트 탐지 영역을 픽셀단위로 예측하는 segmentation-based로 나뉜다. 텍스트 형태가 일정한 사각형이 아닌 폴리곤의 형태일 때, 아래 그림 (b)처럼 탐지 박스의 네 좌표를 결괏값으로 갖는 regression based는 폴리곤 영역을 제대로 잡기가 힘들다. 좀 더 다양한 텍스트 형태를 탐지하기 위해서 고안된 segmentation based 방법은 아래 그림 (c)처럼 형태 자체는 잘 잡지만, 구분되어야할 텍스트 라인이 합쳐져서 잡힌다는 문제점이 있다. ‘we won’t go back,’ 과 ‘we will fight back!’ 텍스트는 각각 다른 텍스트 인스턴스로 분리되어 잡혀야 맞지만, 텍스트 간의 간격이 가깝다보니, 여러 개의 텍스트 인스턴스들을 하나의 텍스트 박스로 인식(conglutination)하는 문제점이 발생한다.

PAN++(선행연구 PSENet, PAN)는 위 문제점을 해결하기 위해 고안된 모델로, 서로 다른 텍스트 인스턴스를 구분짓기 위해서 텍스트 영역 라벨링을 텍스트 영역, 텍스트 커널, 그리고 텍스트 인스턴스, 총 세 가지로 구분하여 모델학습을 진행하고, Pixel Aggregation 기법을 사용해서 텍스트 인스턴스들을 구분한다.

** Regression-based와 Segmentation-based가 궁금하다면 이 링크 참조
(a) 원본 이미지 (b) regression based 탐지 결과 (c) segmentation based 탐지 결과 (d) PAN++(segmentation based) �탐지 결과

(a) 원본 이미지 (b) regression based 탐지 결과 (c) segmentation based 탐지 결과 (d) PAN++(segmentation based) 탐지 결과

Model Architecture

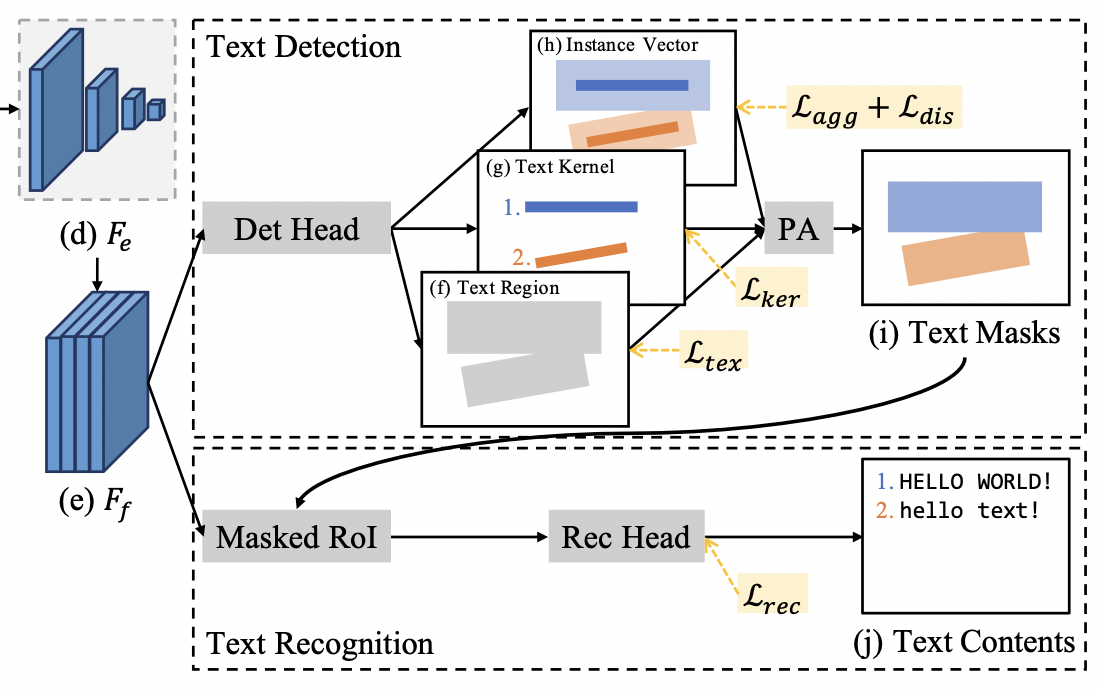
PAN++ 모델의 모델 구조는 크게 backbone, neck, head 세 단계로 이루어져있다.
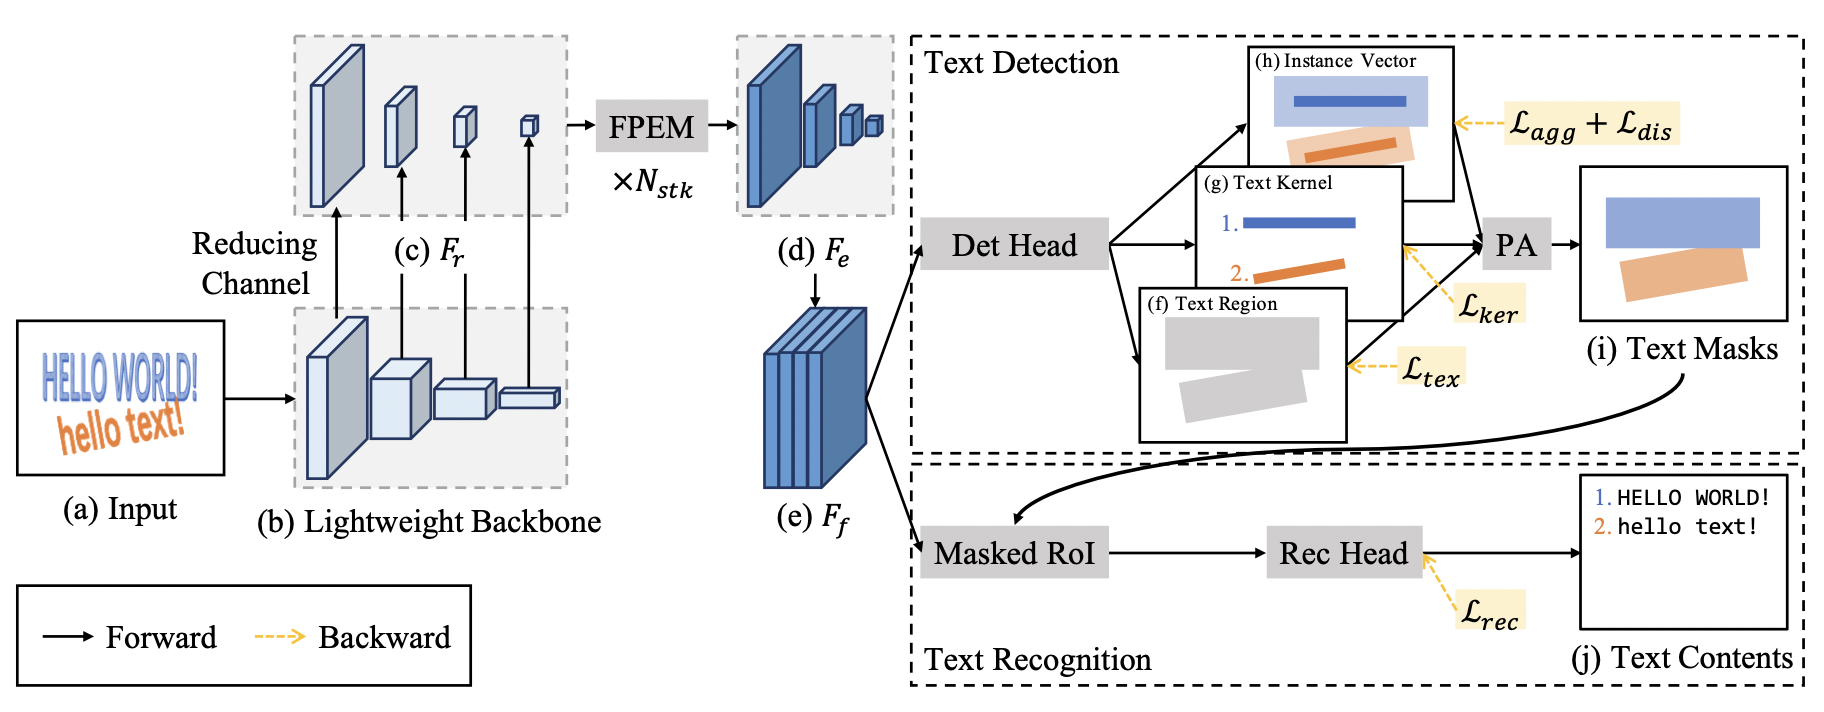
PAN++ 모델 구조

PAN++ 모델 구조

1. backbone​

인풋 이미지로부터 featuremap을 추출하는 백본망으로는 resnet18, 50, 101을 제공한다.

백본망의 결과값으로는 인풋 이미지에 상응하는 featuremap이 총 4판이 나오는데, 각각 인풋 이미지 해상도의 1/4, 1/8, 1/16, 1/32를 갖는다. (다운샘플링하는 컨볼루션(kernel_size = 1, stride = 2)를 여러번 거칠수록, 해상도는 줄어들고, feature level은 높아진다. 해상도 1/32 featuremap은 해상도 1/4 featuremap보다 해상도는 낮지만, 더 high-level feature를 갖는다.)

이렇게 4가지의 해상도로 나누어서 featuremap을 추출하는 이유는 다양한 feature-level의 표현력(representation)을 학습에 잘 반영하기 위함이다.
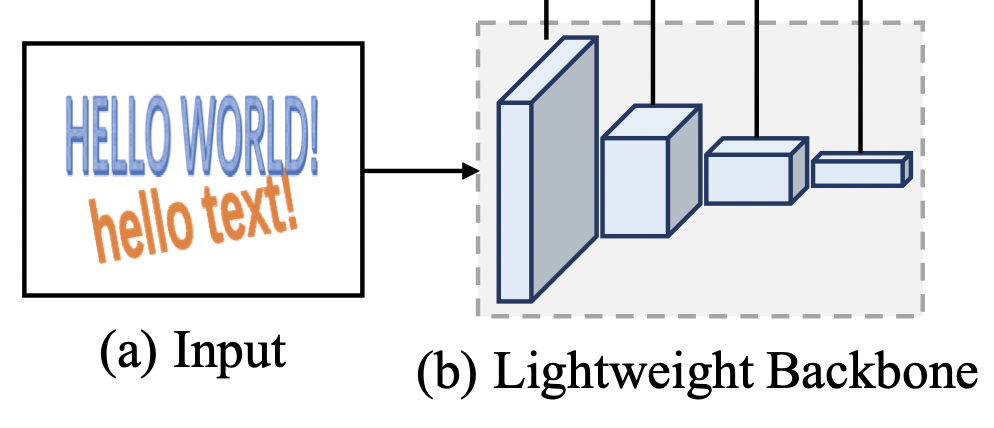
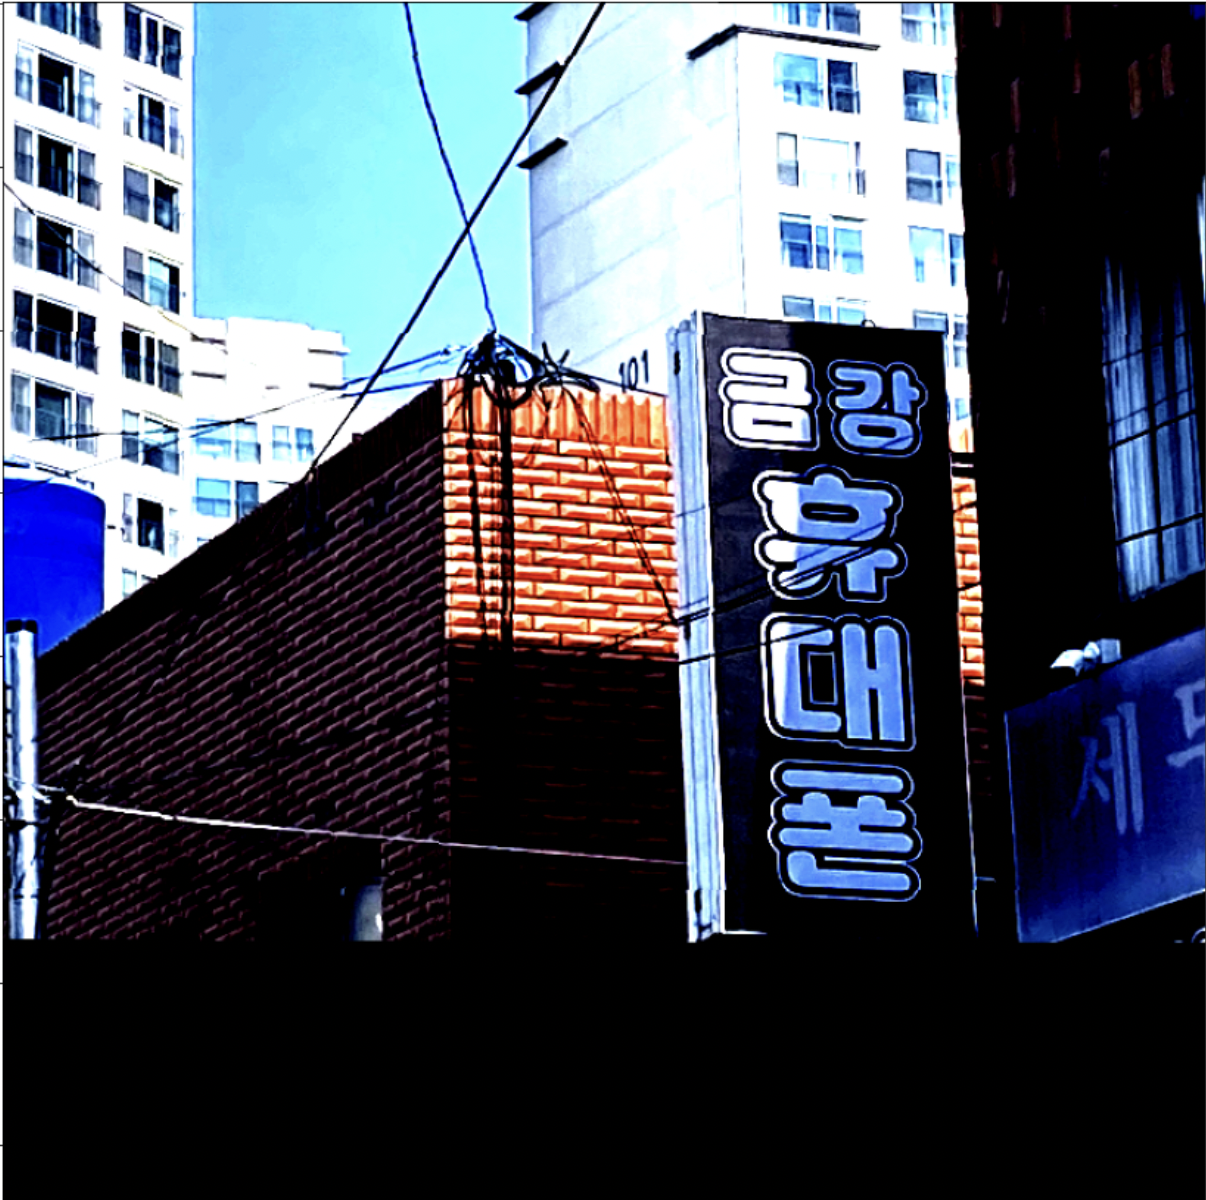
백본 인풋 (a)과 아웃풋 (b). 결괏값은 왼쪽부터 오른쪽으로 인풋이미지의 1/4, 1/8, 1/16, 1/32 해상도를 갖는다.

백본 인풋 (a)과 아웃풋 (b). 결괏값은 왼쪽부터 오른쪽으로 인풋이미지의 1/4, 1/8, 1/16, 1/32 해상도를 갖는다.

2. neck​

4개의 featuremap은 컨볼루션 레이어를 거쳐 채널수를 128개로 고정되고(그림의 Reducing Channel 단계), N_stk개의 FPEM 모듈을 거쳐 인풋의 1/4 해상도와 512개의 채널을 갖는 아웃풋으로 변환된다. FPEM(Feature Pyramid Enhancement Module)은 마찬가지로 다양한 feature-level의 표현력을 학습에 반영하고, 신경망 층이 깊어짐에 따라 학습되어야할 값들이 희미해지는(gradient vanishing) 문제를 보완하기 위한 모듈이다.

** FPEM에 대해서 좀 더 궁금하다면 이 링크를 참조
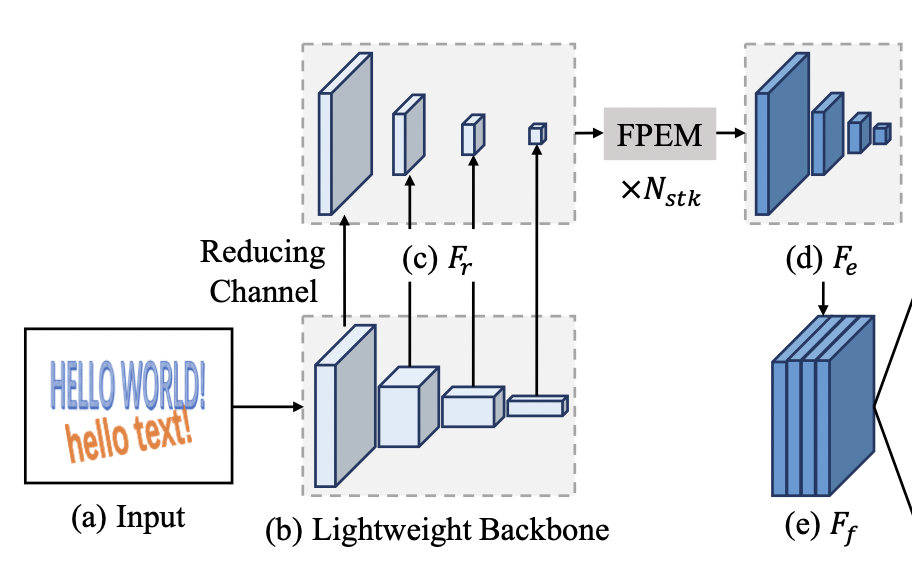
스크린샷 2021-12-26 오후 2.47.44.png

3. head​

스크린샷 2021-12-26 오후 3.24.06.png

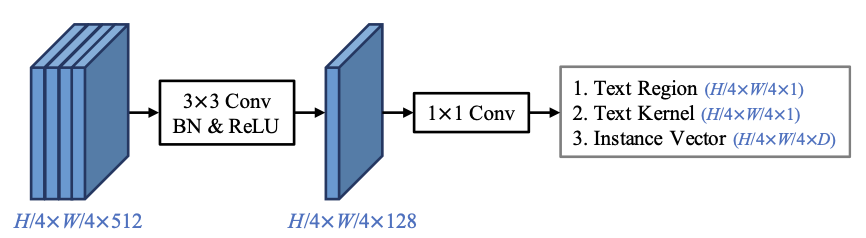
neck에서 받은 H/4∗W/4∗512H/4*W/4*512 형태의 featuremap(위 그림 (e) FfF_f )을 활용해서 Text Region, Text Kernel, Instance Vector에 대한 세 가지 아웃풋을 예측한다. 세 가지 아웃풋을 종합해서 Pixel Aggregation 기법으로 최종 아웃풋에 해당하는 Text Masks를 도출한다. 그리고 Text Masks로 얻은 텍스트 영역(Masked RoI; FfF_f 위 Text Masks 영역을 투영(reflect)시킴)에서 텍스트가 어떤 문자인지 예측하는 텍스트 인식(STR) 단계를 수행한다. 이 중 우리는 Text Region, Text Kernel, Instance Vector가 무엇인지 그리고 어떻게 Pixel Aggregation을 통해 최종 아웃풋을 도출하는지 집중해서 살펴볼 것이다.

PAN++의 아웃풋 형식

텍스트 이미지를 라벨링(또는 어노테이션)하는 방법은 여느 이미지 라벨링과 비슷하다. 텍스트 인스턴스의 단위를 어떻게 설정할지나 라벨링에 [UNK]와 같은 특수한 태그를 추가해서 데이터 처리에 활용하는 등 세부적인 사항에서 그 편차가 있을 수 있겠지만, 텍스트 영역에 4점 이상의 박스를 그리고, 텍스트 내용으로 라벨링하는 것이 일반적이다. 원하는 결과를 도출하기 위해서 이 보편적인 라벨링을 PAN++에서는 어떤 식으로 활용하는지 주목하자. (라벨링 형태 자체를 변환하기 위해서는 많은 비용이 들기 때문에, 딥러닝 모델들은 기존의 라벨링을 잘 활용해서 독창적인 기법을 만들어내곤 한다.)
보편적인 텍스트 라벨링

PAN++는 이 보편적인 라벨링을 Text Region, Text Kernel, 그리고 Instance Vector, 총 세 가지의 값을 활용한다.

  • Text Region : 라벨링된 텍스트 박스와 동일하다. Segmentation map에 cv2.drawContours 함수로 마킹한다. 형태는 원본 이미지 기준 H/4∗W/4∗1H/4*W/4*1 형태다.
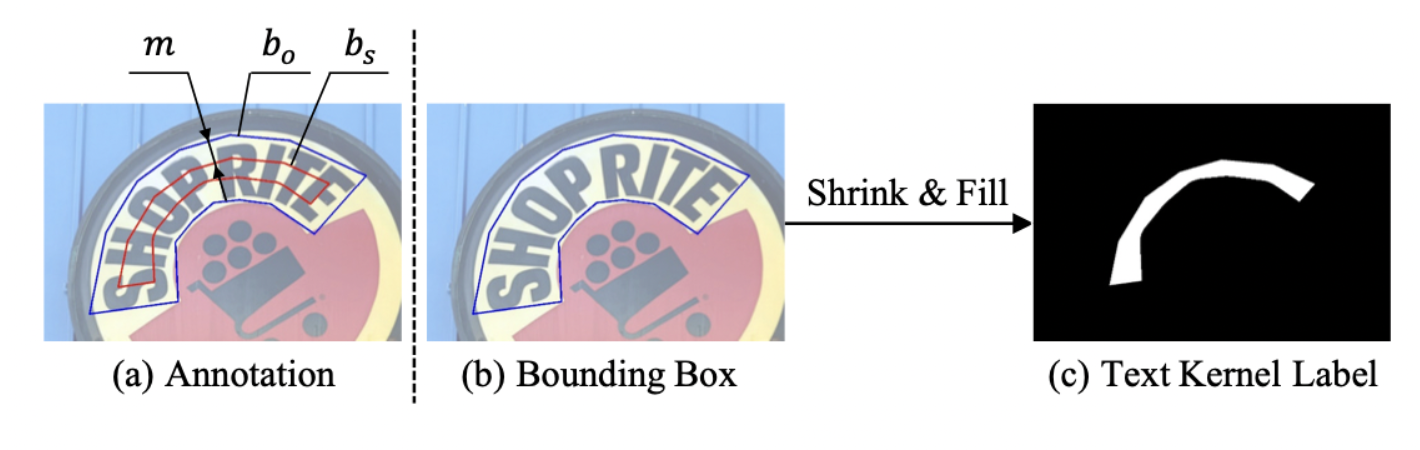
  • Text Kernel : 서로 다른 텍스트 인스턴스들이 가까워서 하나의 인스턴스로 잡히는 문제(conglutination)를 해결하기 위해서 고안되었다. 아래의 그림처럼 Text Region을 텍스트 박스 중심으로 응축(shrink)시킨다. shrink 구현은 pyclipper 모듈을 활용한다. 형태는 원본 이미지 기준 H/4∗W/4∗1H/4*W/4*1 형태다.
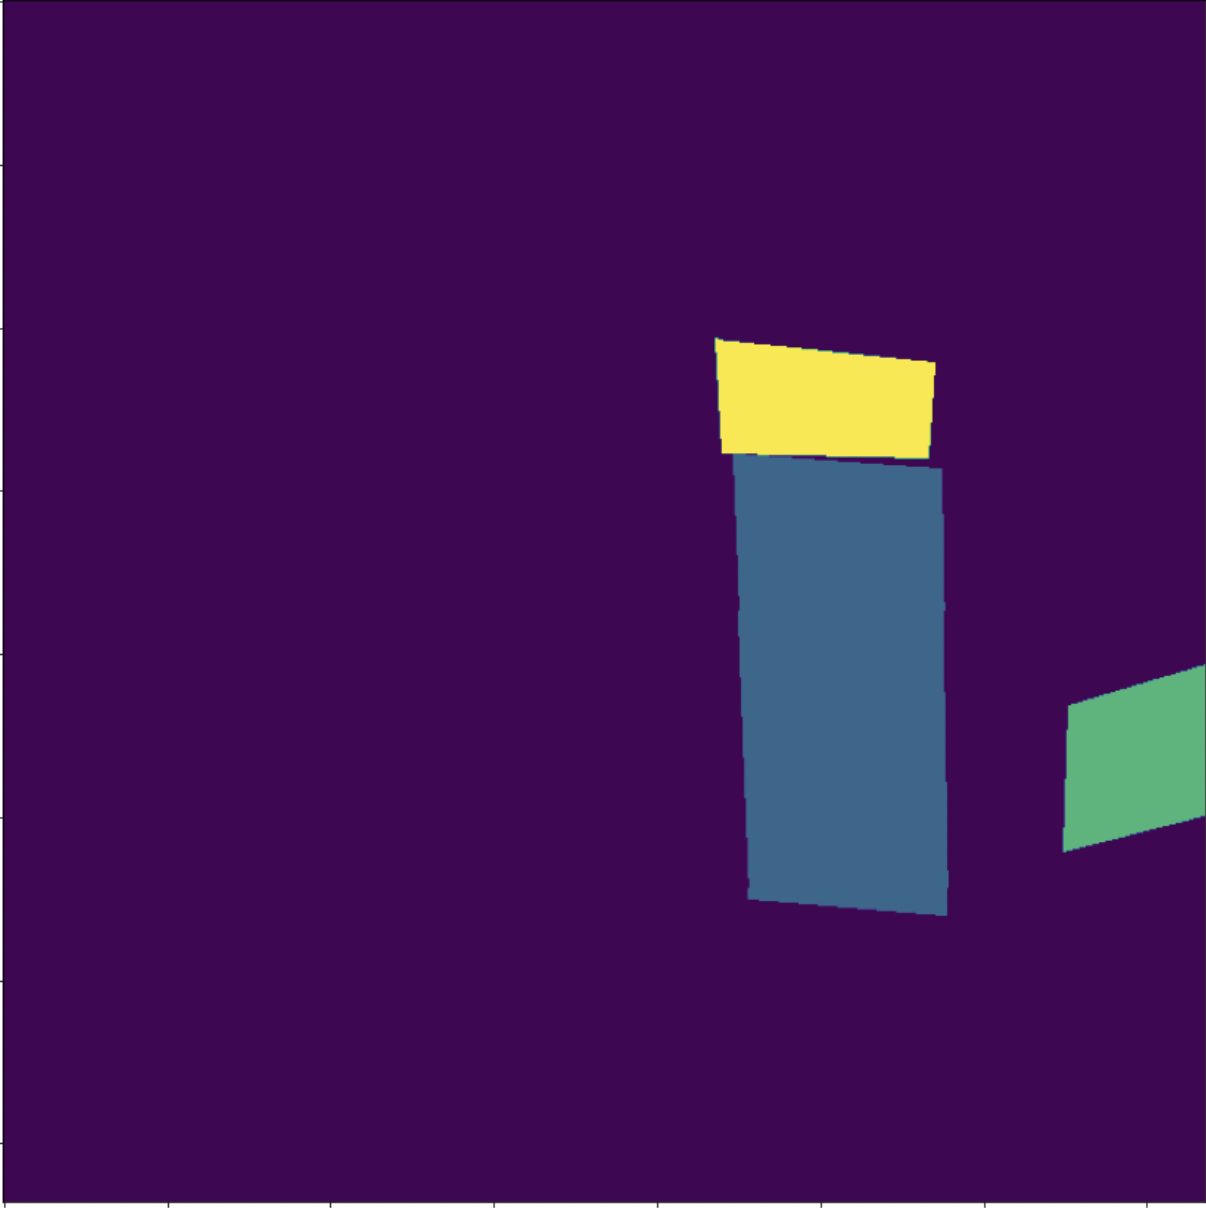
  • Text Instance : Text Kernel과 마찬가지로 위 conglutination 문제를 해결하기 위해서 고안되었다. 각 텍스트 박스는 고유한 Text Instance이다. Segmentation map에 cv2.drawContours 함수, for loop와 enumerate 함수로 서로 다른 픽셀값으로 색칠하여 고유한 인스턴스를 마킹한다. (영역이 겹칠 경우, 뒤에 오는 인스턴스 넘버로 마킹?) 형태는 원본 이미지 기준 H/4∗W/4∗DH/4*W/4*D 형태다. (코드 상에는 D=4)D=4)

텍스트 라벨링에서 text kernel을 도출하는 방법

텍스트 라벨링에서 text kernel을 도출하는 방법

스크린샷 2021-12-27 오전 9.53.05.png

아래는 PAN++의 아웃풋 예시이다.

원본 이미지

원본 이미지

Text Region

Text Region

Text Kernel(Text Region보다 중심으로 응축된 영역)

Text Kernel(Text Region보다 중심으로 응축된 영역)

Text Instance (고유한 텍스트 박스 마스킹)

Text Instance (고유한 텍스트 박스 마스킹)

손실 함수

이제 우리에게 Text Region, Text kernel, 그리고 Text Instance에 대한 정보가 생겼다. 이 정보를 Train 단계에서 어떻게 활용해야 가까운 두 개의 텍스트가 겹치지 않고 서로 다른 텍스트 인스턴스로 구분되면서 텍스트 영역을 충분히 커버할 수 있을까?
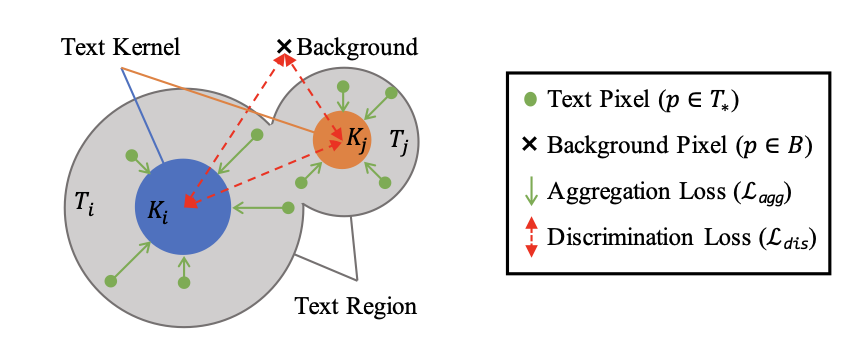
text kernel i(ki; 파랑)는 text region만큼 확장하지만, 다른 커널(주황색)과 겹치지 않아야한다.

text kernel i(ki; 파랑)는 text region만큼 확장하지만, 다른 커널(주황색)과 겹치지 않아야한다.

탐지 손실함수는 text loss, kernel loss, 그리고 emb loss 총 세 종류의 loss의 합으로 이루어진다.
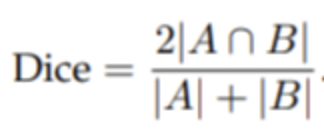
스크린샷 2021-12-26 오후 10.57.10.png

  • text loss : 텍스트 영역에 대해서 dice loss 적용. dice loss는 예측값과 정답값 간 겹치는 영역을 2로 곱한 후, 예측값과 정답값을 더한 값을 나누는 손실함수로 segmentation based 모델에서 자주 쓰인다.

  • kernel loss : 텍스트 커널에 대해서도 마찬가지로 dice loss를 적용한다.

  • emb loss : Text kernel은 Text Region이 응축된 영역이기 때문에, 다른 인스턴스와 겹칠 일은 거의 없다. 이 텍스트 커널에서 픽셀 영역을 조금씩 확장해나가면 어느 지점에서는 Text Region을 충분히 커버하지만, 거기서 더 나아가게되면 다른 Text Instance와 겹치게 된다. 모델의 학습방향은 Text Kernel이 1) 다른 인스턴스 영역과는 구분(discrimination loss)되면서, 2) Text Region만큼은 확장(aggregation loss)하는 것이다.

    aggregation loss
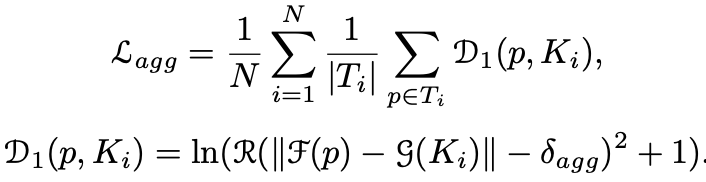
    F(p) = instance vector, g(K) = instance vector of text kernel. D1은 instance vector와 instance kernel 간의 거리를 나타낸다

    F(p) = instance vector, g(K) = instance vector of text kernel. D1은 instance vector와 instance kernel 간의 거리를 나타낸다

    discrimination loss
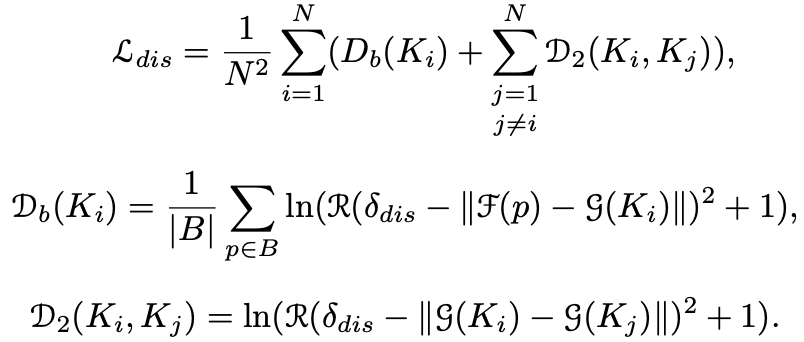
    background와 인스턴스 간의 거리와 서로 다른 인스턴스 간의 거리를 나타낸다. 서로 다른 인스턴스 간의 거리를 계산하기 위해서 torch.repeat 과 torch.eye 를 활용한 것이 주목할만 하다.

    background와 인스턴스 간의 거리와 서로 다른 인스턴스 간의 거리를 나타낸다. 서로 다른 인스턴스 간의 거리를 계산하기 위해서 torch.repeat 과 torch.eye 를 활용한 것이 주목할만 하다.

Pixel Aggregation

위 손실함수를 잘 반영해서 학습하면, 꽤 정교한 아웃풋(text region, kernel, instance)을 얻을 수 있다. 더 정교한 결과를 위해서 PAN++는 inference단계에서는 pixel aggregation 기법을 사용한다.
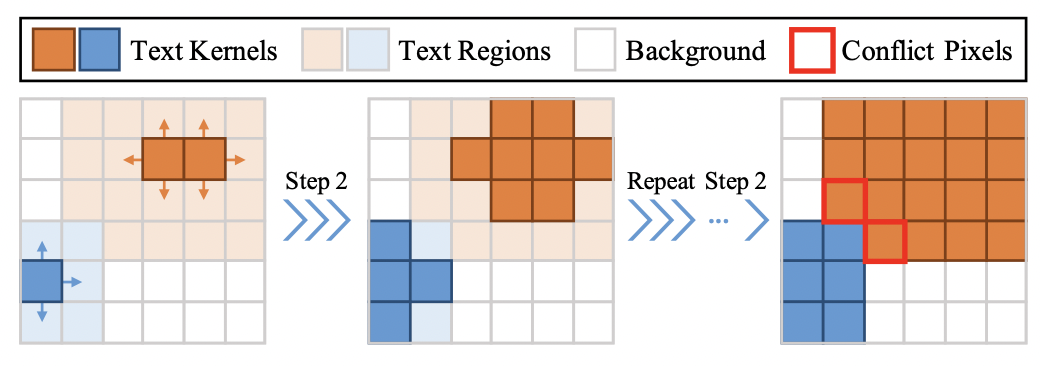
스크린샷 2021-12-27 오후 3.10.40.png

  1. 결괏값(코드상 kernels, emb)에 대해서 connected component 기법을 적용한다. (connected component 기법은 같은 값을 갖는 인접한 픽셀들을 그룹화해주는 기법이다) 그룹화된 pixel들은 text kernel과 같은 의미를 갖는다.
  2. 각각의 kernel은 4방향으로 픽셀을 확장해나간다(BFS와 같은 방식). 탐색하는 픽셀의 instance vector 간의 유클리디언 거리가 d보다 작을 경우에만 확장하여, 다른 instance들과 겹치는 일이 없도록 한다
  3. 근접 픽셀이 없을 때까지 두번째 스텝을 반복한다.

해당 pixel aggregation 코드는 Cython으로 짜여있다. 파이썬에서 cv2나 numpy 라이브러리를 활용해도 충분히 구현이 가능하지만, 속도가 느린 편인데, 해당 코드는 정말 빠르다. Cython으로 다른 python code들과 함께 구동가능하다는 점도 주목할만하다.

Outro

End2End Text Spotting 모델 PAN++의 텍스트 탐지(STD) 부분에 대해서 살펴보았다. PAN++는 실제로 다른 우수한 텍스트 탐지 모델들(CRAFT)과 비교했을 때, 굉장히 성능도 잘 나오고 빠른 편이다. 모델 구조, 라벨링을 활용하는 방법, 커스텀한 손실함수, 그리고 inference 시 후처리까지 아주 꼼꼼하게 설계되어 있기 때문에 가능한 성능이지 않나 싶다.

해당 논문과 모델 코드까지 천천히 뜯어보면서 논문 하나(모델 하나)를 만들기 위해서 저자들이 얼마나 많은 실험과 머리를 쥐어짜는 고심을 했을지 생각해보았다. 모델을 구성하는 단계마다 최신/최선의 기법들을 적용해서 0.001%의 정확도라도 더 끌어올리려고한 노고가 느껴졌다. 이 글에 논문의 최대한 많은 내용을 담으려고 노력했지만, 모델의 STR 부분, 모듈 구성 시의 builder 패턴, 학습 시의 ohem 기법, pixel aggregation의 cython 익스텐딩 등 커버하지 못한 부분도 많다. (누락된 부분에 대해서는 차차 살펴보면서 머릿속에 익히려고 한다)

한편으로 코드를 천천히 뜯어보고 정리하면서 배운 점 또한 많다.

  • 모델을 구성하는 모듈들은 어떻게 정리하는 게 깔끔한지 알게 되었다. (CRAFTS 코드 구현할 때, 가장 힘들었던 부분이 코드가 지저분한데, 방대한 양을 어떻게 정리해야할지 모르겠었다는 것)
  • 가지고 있는 데이터를 활용해서 원하는 아웃풋을 만들어내는 것도 모델 성능을 높이기 위한 하나의 방법이라는 것을 알게 되었다. (높은 정확도까지 보장된다면 새로운 논문이 나올지도..?)
  • 그 외에 자잘한 함수들(torch.Conv2d 의 groups 인자, torch.repeat 과 torch.eye 로 두 개의 for문 처리 등등..)

OCR이란?

· 약 15분
eunsung shin
Software Engineer

Intro​

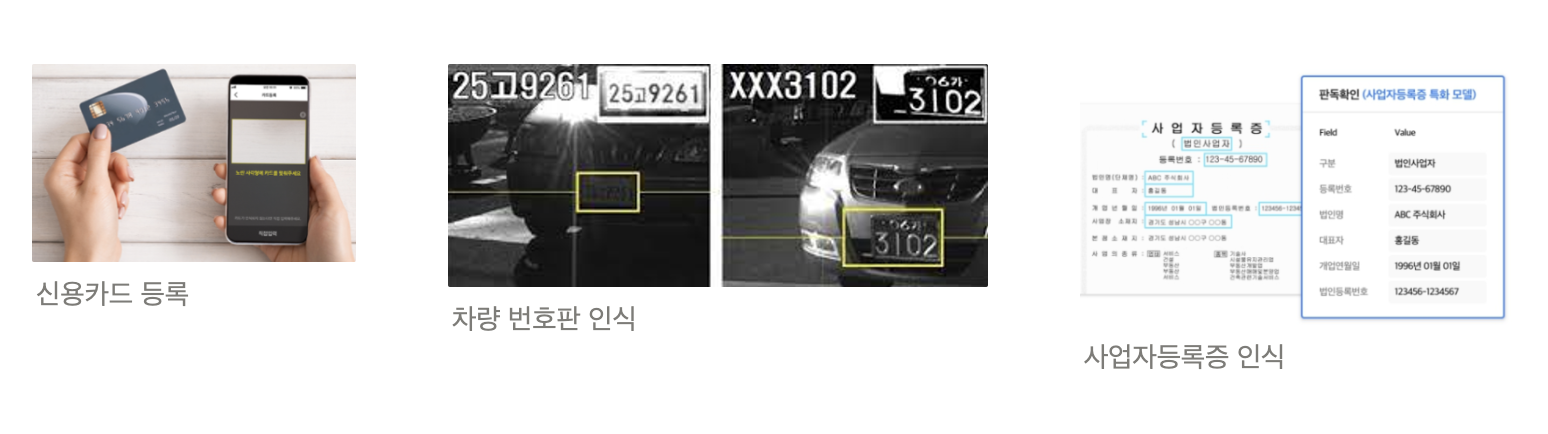
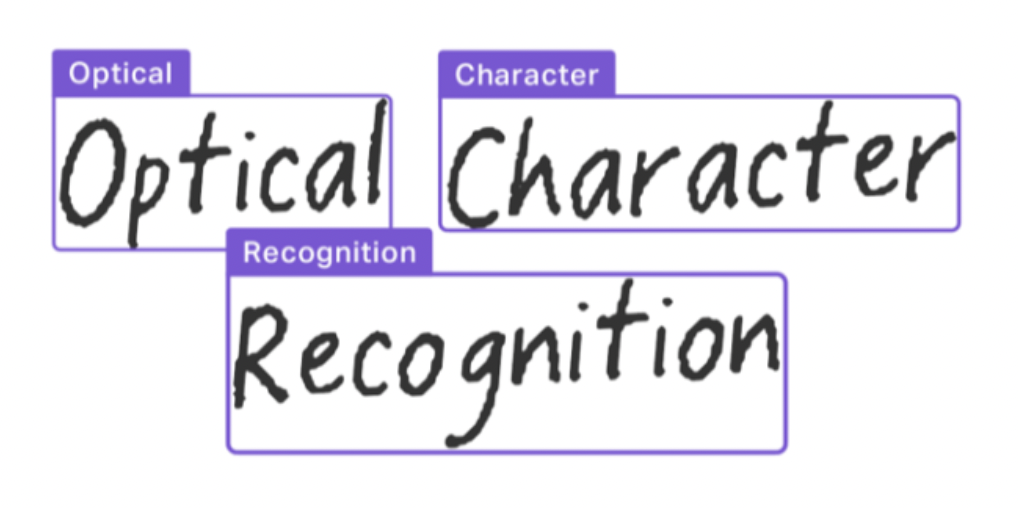
OCR(Optical Character Recognition)은 이미지 속의 글자를 읽는 기술이다. 조금 생소할 수도 있는 이름인 OCR은 생각보다 우리의 일상 속 깊숙이 자리하고 있다. OCR은 신용카드, 사업자등록증이나 주민등록증, 또는 영수증 등 필요한 서류 정보를 촬영만 하면 전자 정보로 변환 가능하게 해준다. 또, 차량번호판 정보를 추출해서 불법 주차나 속도 위반 차량을 파악하기도 한다. 그리고 아직 종이 문서에서 전자 문서로의 전환이 진행중인 기업들이 한 장씩 문서 내용을 직접 체크해야하는 부담을 줄여 업무 자동화를 가속화해준다. 유입되는 데이터의 크기가 커지고 있는 빅데이터 시대에 사는 우리에게 '사람의 눈을 일일히 거치지 않고 이미지에서 필요한 텍스트 정보만을 추출할 수 있게 되었다'라는 것은 빅데이터를 우리의 편의에 맞게 더 잘 활용할 수 있는 옵션이 생겼음을 의미한다.

OCR이 실생활에 사용되는 예

2019년, AI 자동차수리비 산출시스템 프로젝트를 진행중이였을 때였다. 파손된 차량의 사진을 휴대폰 촬영해서 앱에 업로드하면 수리 금액이 얼마가 나올지 예측하는 이미지 딥러닝 모델을 개발 중이였다. 여느때처럼 퇴근하고 집에 돌아가는 길, 같은 지하철을 타는 팀장님에게 이런 질문을 했었다.

'저희 프로젝트처럼 사물 자체가 아닌 사물의 손상 심도까지 파악할 정도로 이미지 모델의 성능이 좋다면, 글자들을 인식하는 것도 상품화가 가능하지 않을까요?'

그 때 팀장님의 답변은 아직도 기억에 남는다.

"이미지 모델의 형태가 점점 발전하고 있기는 하지만, 결국 이미지 안의 물체의 영역을 탐지하고, 해당 물체가 미리 정의해놓은 클래스의 범주 내에서 분류되는 이미지 모델의 틀은 쉽게 변하기 힘들어요. 한글로 나올 수 있는 한 글자짜리 조합만 생각해도 대략 6, 7천개(링크)쯤은 될 거고, ****거기다 종이 한장에 보통 글자가 못해도 300개 400개 쯤은 될 거예요. 그럼 그 문서 한 장에 나오는 글자들을 모두 올바르게 맞출 확률은 얼마나 될까요? 그리고 이 글자 읽는 태스크를 컴퓨터로 대체하려면 적어도 100장 이상, 아니 10,000장 정도는 거뜬히 처리할 줄 알아야 현장에 사용이 가능할 텐데, 그렇게 된다면 정확도는 얼마 정도가 보장될까요? 그런데 또 모르죠. 나중에는 그 정확도를 확 올릴 수 있는 기술들이 나올수도..."

자고 일어나면 최신 기술들이 뒤바뀔만큼 미친 속도로 새로운 기술들이 쏟아져 나왔고, 왜 문서를 AI 이미지 모델로 처리해서 정확도를 뽑는 게 힘든지 설명을 해주셨던 팀장님과 우리 팀은 2년째 OCR 제품을 개발중이다.


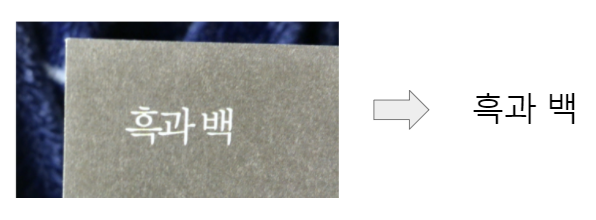
OCR. 컴퓨터가 사람 대신 글을 읽어주는 일.​

OCR. 이미지를 보고 컴퓨터가 인식할 수 있는 문자로 변환하는 일.

OCR. 이미지를 보고 컴퓨터가 인식할 수 있는 문자로 변환하는 일.

OCR은 어떻게 이뤄질까?

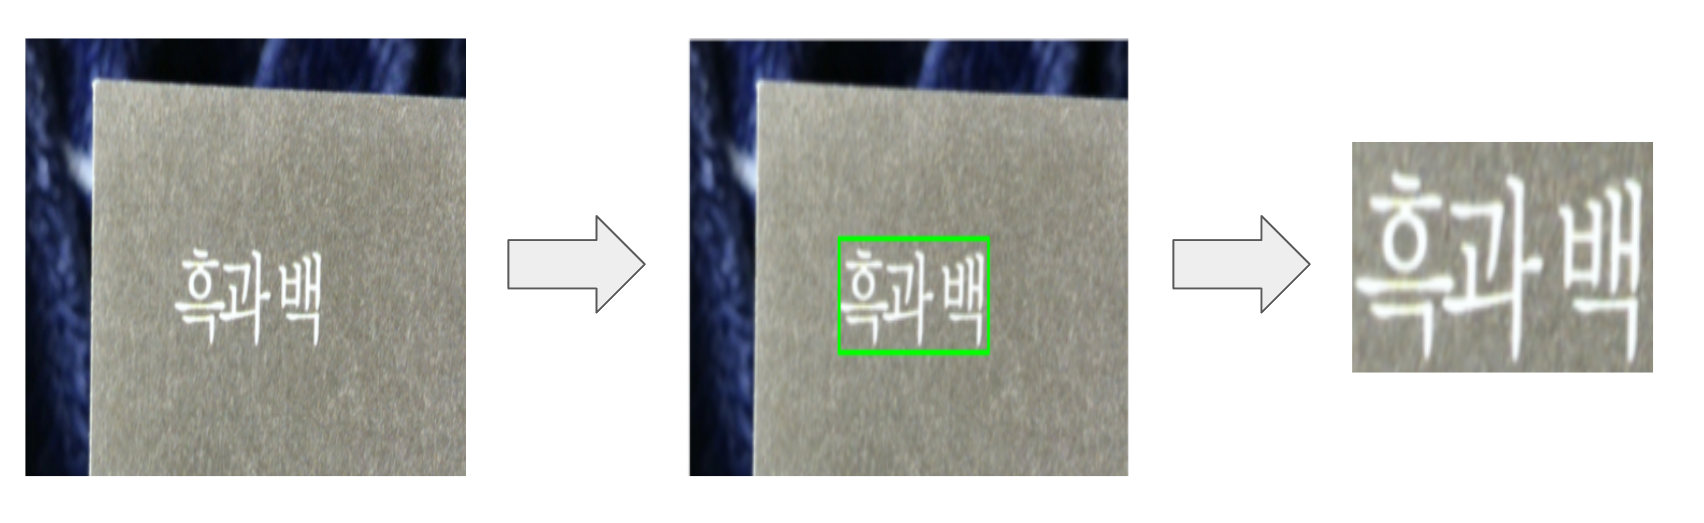
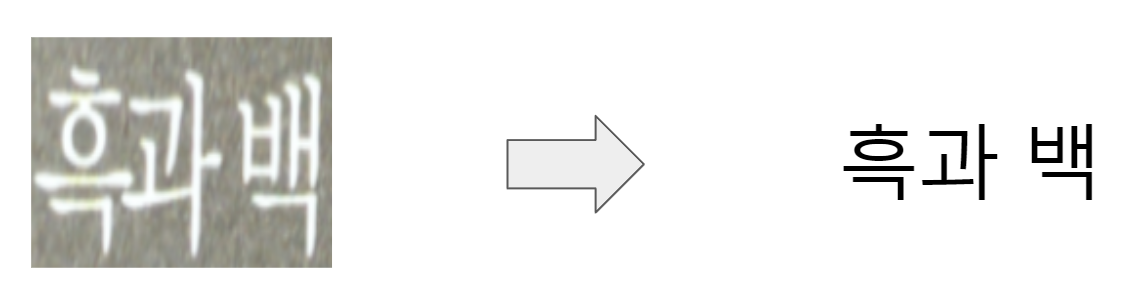
회사마다 어떤 모델을 쓰고, 어떤 단계에 기준을 두고 모델을 설계하는지는 조금씩 다르겠지만, 보통 OCR은 2단계 또는 3단계로 이루어진다. 2단계는 이미지 중 텍스트 영역을 탐지하는 1)문자 영역 탐지(STD)단계와, 탐지한 영역의 텍스트를 인식하는 2)문자 인식(STR)단계, 그리고 문서 이미지의 경우 인식한 텍스트 정보를 분류하고 구조화하는 3)문서 이해(Document Understanding) 단계까지 3단계로 구성된다.


1. 문자 영역 탐지 (Scene Text Detection;STD)​

이미지에는 한 개 이상의 문자 영역이 존재할 수 있다. 정확한 문자 인식을 위해 문자가 속하는 영역을 탐지한다. 잘못 잘린 문자 영역은 문자 인식의 성능을 떨어트리지만, 반대로 알맞게 잘린 문자 영역은 문서 이해(Document Understanding) 단계의 알맞은 단위로 작용한다.

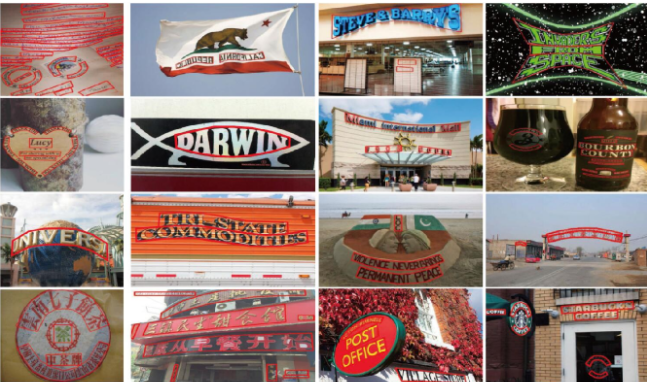
Scene Text Detection 관련 최신 모델들의 정보는 **여기**에서 찾을 수 있다.


2. 문자 인식 (Scene Text Recognition;STR)​

STD(문자 영역 탐지)단계에서 잘라낸 문자 이미지로부터 컴퓨터 문자로 인식하는 단계이다. 보통 글자 하나 하나를 개별로 인식하는 것이 아니라, 1개 이상의 글자로 이루어진 단어 단위로 인식한다. 글자가 1개 이상이다 보니, 글자와 글자 간의 순차적 종속성(sequential dependency)이 존재한다. 예를 들어, 앞에 두 글자가 '아이스크'였다면 그 다음에 오는 글자는 '림'일 확률이 높다. 이런 순차적인(sequential) 특성을 활용하기 위해서, Bi-LSTM, Attention, 그리고 최근에는 Transformer 모델을 활용한다. (이 글에서 Sequential Data를 처리하기 위한 모델들에 대해서 읽을 수 있다.)

STR 관련 최신 모델들의 정보는 여기에서 찾을 수 있다.

3. 문서 이해 (Document Understanding)​

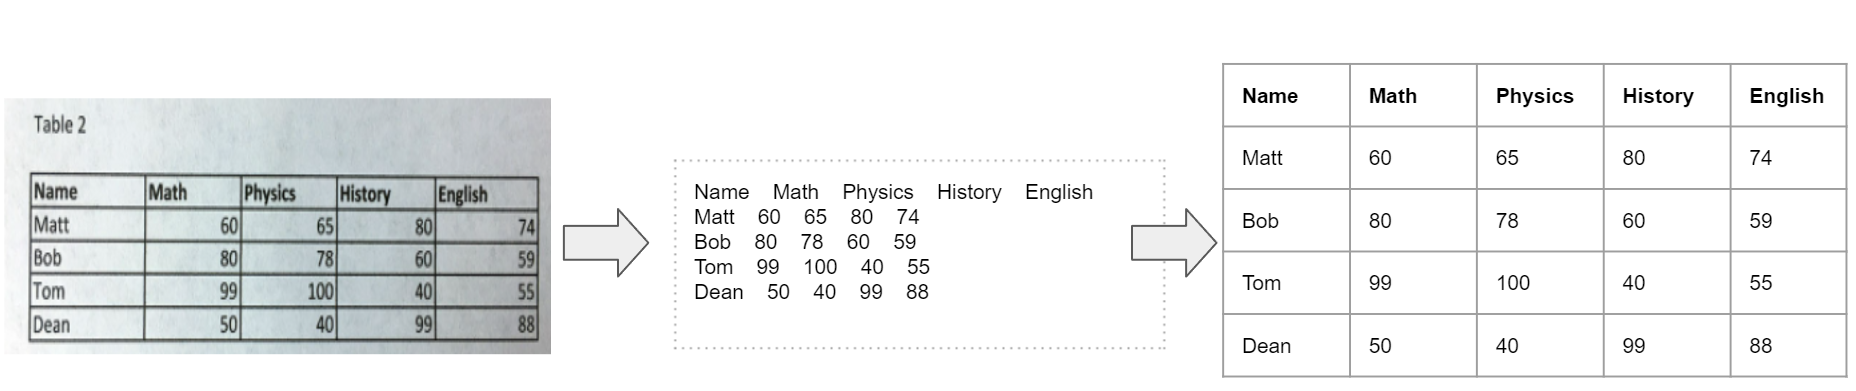
STD와 STR 단계를 무사히 거쳐 원하는 컴퓨터 문자를 추출해냈다고 하자. 다음엔 뭐가 필요할까? 추출해낸 문자들을 컴퓨터가 이해할 수 있는 방식으로 정리하는 작업이 필요하다.

아래 표 이미지를 중앙에 위치한 글자들로 추출해냈다고 하자. 사람은 맨 윗쪽 행이 각 열들을 나타내는 열이름(column name)이라는 것, 그리고 맨 왼쪽의 열은 행이름(row name), 그리고 옆의 행들은 각 행들의 정보를 나타낸다는 사실을 쉽게 알아차릴 수 있다. (Matt의 수학 점수는 60점, 물리학 점수는 65점) 하지만, 컴퓨터는 그렇지 않다. 중앙 글자들(정보)로부터 구조화하는 과정이 필요하다. 올바른 문서 이해 과정을 거친다면, 아래 그림의 세번째 표를 뽑아낼 수 있을 것이다. 참고로, 테이블화한다는 것은 [('Name' : 'Matt', 'Math' : 80, 'Physics' : 65, 'History' : 80, 'English' : 74), ...]와 같이 json, xml 등과 같은 포맷으로 구조화할 수 있음을 의미한다. 여기서 중요한 점은 글자에 대한 정보 뿐만 아니라, 글자의 위치, 그리고 그 글자 주변의 표 성분, 즉 사람이 문맥에 맞춰 글자를 읽기 위해 시각적으로 사용하는 정보들이 문서 이해 과정에서 고려되어야 한다는 것이다.

문서 이해 관련 최신 모델들의 논문 정보는 **여기**에서 찾을 수 있다.

OCR을 하면서 생길 수 있는 문제들​

물론 위 3단계를 문제없이 진행하면 이상적이겠지만, AI 모델에 99.9999%의 정확도는 있더라도 100% 정확도는 없다. 각 단계별 인식 측면에서 다양한 문제들이 발생한다.


1. 문자 영역 탐지(STD) 단계​

목적 : 인식 대상 텍스트를 이미지로부터 캡쳐

  1. 글자 미탐지/오탐지

    1. 오탈자 발생 ⇒ 문서 이해 단계에서 정보가 빠지는 경우 발생

    2. 오탐지(글자가 아닌 오점을 문자로 인식한 경우)

      ⇒ 인식 단계에서 잘못된 글자로 인식

  2. 탐지 박스 단위

    1. 원래 하나의 박스를 두 개 이상의 박스로 잡는 경우
    2. 반대로 두 개 이상의 박스를 하나로 잡는 경우

    ![10,000를[′10,000를 ['10', '000']으로 탐지했다. 상금 만 달러가 10달러로 줄어든다면 아무도 좋아하지 않을 거다.](misdetection-example.png)

2. 문자 인식(STR) 단계​

목적 : STD단계에서 캡쳐한 텍스트 이미지를 전자 문자로 알맞게 변환

  1. 글자 방향에 따른 오인식
    • 왼쪽에서 오른쪽으로 나열된 단어들만 학습하다가 다른 방향으로 나열(수직이나 오른쪽에서 왼쪽 나열)된 단어 이미지가 들어오는 경우

      직사각형의 글자 이미지가 아니라 폴리곤(polygon) 형태의 이미지가 들어온다면?

  2. 학습 데이터에 기반한 인식 오류
    • 학습한 폰트와 아예 다른(인식이 불가능할 정도의) 폰트를 사용한 텍스트인 경우

    • 숫자 '0'과 자음 'ㅇ', 숫자 '1'과 모음 'ㅣ' 처럼 문맥을 고려하지 않으면 구분하기 힘든 단일 문자들

      손글씨 폰트체다. 과연 고딕체의 직각 글자 이미지를 학습한 모델이 손글씨를 인식할 수 있을까?

3. 문서 이해 단계 (Rule-Based일 경우)​

목적 : 이미지에서 추출한 정보들을 구조화

  1. 기존 유형과 다른 문서 구조에 대한 인식 오류
    1. 같은 문서 유형이지만 문서 구성이 다른 경우
  2. 앞에 STD와 STR에서 오류가 발생한 경우

Outro​

OCR 진행 시 위에 적어놓은 문제 외에도 많은 문제들이 존재한다. 그 중, 현재 OCR 모델 구조 상 해결이 불가능한 문제들이 생기면 머리가 아파진다. 예를 들어, STD모델의 학습 데이터 탐지 단위가 '단어'였는데, '글자' 단위의 탐지가 필요한 경우라거나 Wild-Scene 이미지 인식 시에 사용중인 STR모델의 아웃풋에는 없는 '글자 방향'이 필요한 경우. 그럴 때면, '현재 모델 구조를 유지한 채로 성능을 고도화한다' 첫번째 옵션과 '새로운 모델을 사용한다' 두번째 옵션 중에 갈팡질팡하게 되는데, 이는 결코 쉬운 과정이 아니다.

뭐가 맞을지는 아무도 모른다. 기간 안에 에러를 감안하고도 도달할 수 있는 최고 성능을 뽑아내는 것 외에 정해진 건 없다. 몇 년 전만 해도 내가 OCR제품을 개발하고 있으리라곤 상상도 못 했던 것처럼. 다만, 한 가지 모델만 오래 사용하다보면, 그 모델이 이미지를 처리하는 방식과 뽑는 아웃풋에 사고 구조가 굳어지는 경우가 있는데, 사고가 굳지 않도록 계속해서 새로운 모델 구조를 공부해나가는 과정이 필요하다.

Transformer - handling sequence

· 약 12분
eunsung shin
Software Engineer

서론​

Transformer(Attention Is All You Need) 논문이 나온지도 벌써 4년이 지났다. 어마무시한 성능을 자랑하는 Transformer는 안 쓰이는 곳을 찾기 힘들 정도로 거의 모든 분야의 최신 기술로 스며들고 있다. 이번 Transformer 1편에서는 시퀀스 데이터를 처리하기 위해서 고안된 시퀀스 모델들, RNN, LSTM, Seq2Seq, Attention을 활용한 Seq2Seq, 그리고 마지막으로 Self-Attention에 대해서 간략히 알아보고자 한다. 나는 시퀀스 데이터에 대한 배경 지식이 거의 없다. 그래서, Transformer 구조를 바로 살펴보는 것보다는 시퀀스 데이터들을 처리하기 위해서 어떠한 시도들과 문제점들이 있었는지를 이해하고, 그 문제점들을 Transformer는 어떤 식으로 해결하는지 알아보면 조금 더 와닿을 것 같다는 생각에서 본 글을 작성하게 되었다. 이 글의 최종 목적지는 Vision Transformer에 대한 올바른 이해이며, Transformer 2편에서는 Transformer가 내 관심분야인 컴퓨터 비젼 영역(더 정확히는 OCR)에서 어떻게 적용되었는지 알아보려고 한다.

RNN​

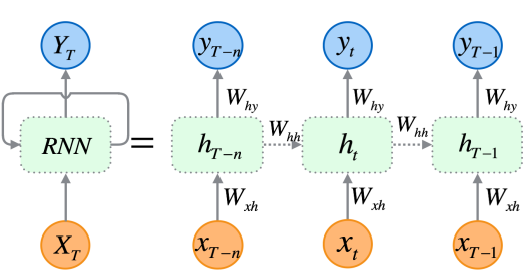
Untitled

RNN, input sequence가 길어지면(time step 증가), 초기에 들어온 인풋 x1,x2,...x_1, x_2,... 들은 필연적으로 뒤에 들어온 xn,xn−1,...x_n, x_{n-1},... 등과의 관계를 비교했을 때, 가중치들이(0과 1 사이의 값) 계속 곱해지면서 연관성이 떨어지게 되는 문제가 있다. (problem of vanishing gradient). 실제로는 연관성이 깊은 두 인풋 벡터들이 단지 거리(time step)가 멀다는 이유만으로 연관성이 없다고 판단될 수도 있다.

LSTM​

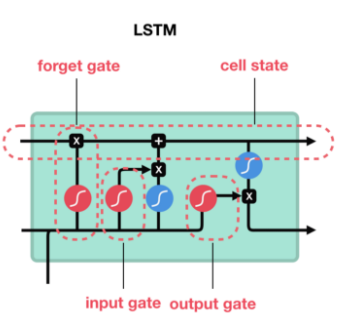
출처: https://towardsdatascience.com/illustrated-guide-to-lstms-and-gru-s-a-step-by-step-explanation-44e9eb85bf21

이를 해결하기 위해 나온 모델이 LSTM(Long Short Term Memory)이다. cell state와 hidden state에서 인풋값 이전의 time step(t-1) 정보들을 받고, sigmoid로 이루어진 3개의 gate들(forget gate, input gate, output gate)을 통해 이전 time step과 현재 input 값에 얼마만큼의 영향력(가중치)을 부여할지 학습한다. 이 영향력(가중치)은 input(과거와 현재 벡터들)에 의해 계산되고, 오래 기억해야할 중요한 time step 인풋에는 더 높은 가중치, 잊어도 되는 덜 중요한 인풋에는 낮은 가중치를 부여함으로써, 위의 RNN이 갖고 있는 vanishing gradient 문제를 보완했다.

Seq2Seq​

[출처 : https://jalammar.github.io/visualizing-neural-machine-translation-mechanics-of-seq2seq-models-with-attention/](seq2seq.mp4)

출처 : https://jalammar.github.io/visualizing-neural-machine-translation-mechanics-of-seq2seq-models-with-attention/

Encoder와 Decoder로 이루어진 Seq2Seq 모델은 Encoder에서 뽑아낸 인풋값 전체의 문맥, 인코딩된 context 벡터를 decoder에서 다시 디코딩하여 결과를 도출한다. Encoder와 Decoder 각각은 RNN으로 구성되어 있다. 과거의 time step 정보들을 순차적으로 고려해 값을 도출하는 RNN과 비교했을 때, Seq2Seq 모델은 Encoder로 인풋값의 전체 문맥을 반영하고 Decoder로 해독한다는 점에서 시퀀스 길이와 순서가 자유롭다는 장점이 있다. 하지만, Context Vector가 bottleneck으로 작용하여 (RNN이나 LSTM과 마찬가지로)인풋 시퀀스가 길어지면 성능이 떨어진다는 단점이 있다.

Attention​

[출처 : https://jalammar.github.io/visualizing-neural-machine-translation-mechanics-of-seq2seq-models-with-attention/](attention.mp4)

출처 : https://jalammar.github.io/visualizing-neural-machine-translation-mechanics-of-seq2seq-models-with-attention/

Attention 모델은 Encoder-Decoder Network(e.g. Seq2Seq)가 Context Vector에 의존하기 때문에 생기는 bottleneck 문제를 보완한다. Encoder 단계에서 각 time step마다 나오는 hidden state들을 context vector처럼 넘기고, Decoder 단계에서 각 time step에 대한 Decoder hidden state와 Encoder hidden state들과의 관계를 내적(dot product)으로 계산한다. 내적 후 softmax를 거친 이 값은 Decoder hidden state가 각 Encoder hidden state들과 각각 얼마만큼 집중해야할지 제시하는 attention score가 된다.

LSTM이 해당 time step 직전의 정보에 대해서만 가중치를 계산했다면, Attention은 아웃풋 시퀀스의 각 step에 대해서 인풋 시퀀스의 각 step들이 얼마만큼의 가중치를 가져야할지를 계산한다.

Transformer (Self-Attention)​

출처 : https://jalammar.github.io/illustrated-transformer/

출처 : https://jalammar.github.io/illustrated-transformer/

Attention의 근본적인 핵심은 두 개의 시퀀스, Seqa=[va1,va2,...,van]Seq_a=[{v_{a_1}, v_{a_2},...,v_{a_n} }]과 Seqb=[vb1,vb2,...,vbm]Seq_b=[{v_{b_1}, v_{b_2},...,v_{b_m} }], 가 있을 때, vb1v_{b_1}에 대해서 va1,va2,...,vanv_{a_1},v_{a_2},...,v_{a_n} 이 갖는 영향력(가중치, 또는 관계)을 뽑는다는 것이다.

그렇다면 만약 이 영향력 뽑는 과정을 Sequence 스스로에게 적용한다면??

'A dog devoured his treat, because he was hungry.' 라는 문장에 attention을 적용한다면, 'dog', 'his', 'he' 간의 attention score는 꽤나 높게 나올 것이다. 또한, attention 과정을 통해 뽑은 vector는 일반 linear layer를 거친 vector보다 sequence 맥락을 좀 더 잘 반영한 vector일 것이다.

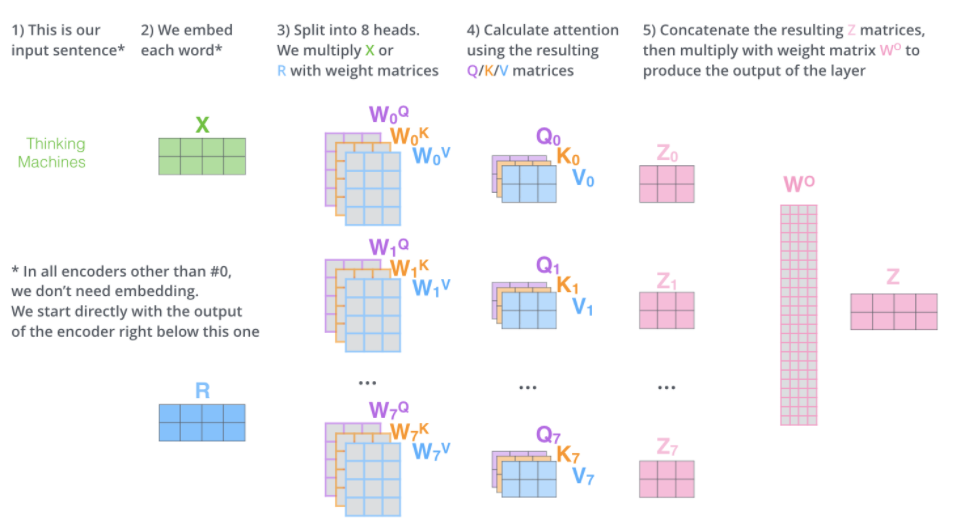
이렇게 시퀀스 스스로에게 attention을 적용하는 기법을 self-attention이라고 한다. 그리고 오늘 글의 주제인 Transformer는 self-attention 구조를 여러 개 합쳐서 만든 multi-head attention을 활용한다.

출처 : https://jalammar.github.io/illustrated-transformer/

출처 : https://jalammar.github.io/illustrated-transformer/

  1. key, query, value

여기서 주목할 점은 attention을 구하는 로직 자체는 똑같지만, Query, Key, Value 벡터들을 활용한다는 점이다. 시퀀스를 이루는 인풋 벡터들은 Query, Key, Value 한 세트씩을 갖게된다. Query 벡터는 해당 인풋 벡터와 나머지 벡터들 간의 관계를 질의(query)하는 역할이다. Key 벡터는 나머지 벡터들이 Query 벡터로 질의했을 때, 제공하는 해당 인풋 벡터가 가지고 있는 열쇠의 역할이다. 그리고 Value 벡터는 해당 인풋 벡터가 linear layer를 거친 값이라고 보면 된다.

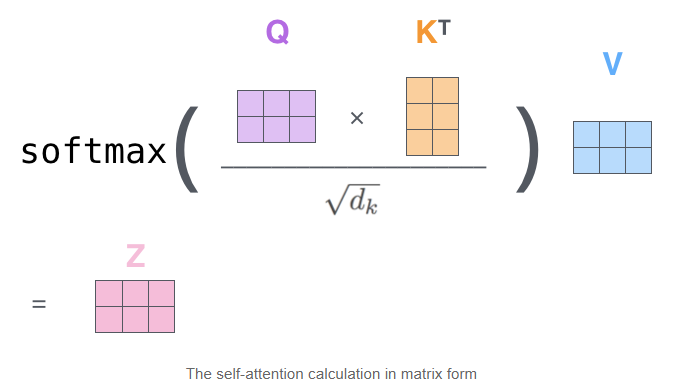
직관적으로 설명하자면, 인풋 벡터가 다른 벡터들에게 질의할 때는 Query 벡터로, 다른 벡터가 질의할 때는 Key 벡터로 응답한다고 생각하면 된다. 이 Query 벡터와 Key 벡터는 내적과 softmax, 그리고 dk\sqrt{d_k} 로 정규화를 거쳐서 Attention Score를 뽑는다. 이 내적하는 과정은 여기에서 봤듯이, Query와 Key 벡터 간의 유사도를 보는 것과 같은 의미를 갖는다. (즉, Query가 열쇠구멍이라고 한다면, Key는 그 열쇠구멍과 열쇠가 얼마나 맞는지를 의미한다.) 그리고 Attention Score는 linear layer를 거친 것과 같은 값인 Value 벡터와 곱해진다.

  1. positional encoding

    Untitled

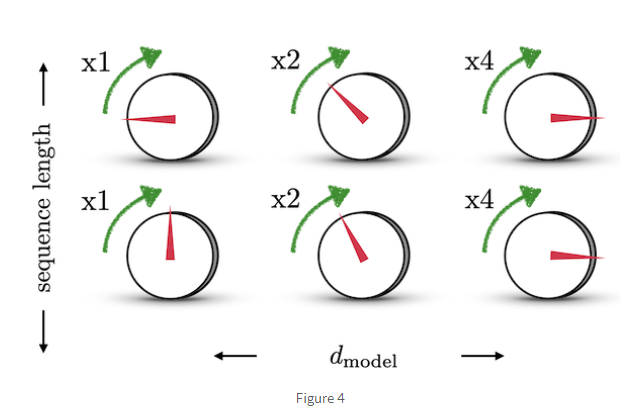
이렇게 kqv 연산을 통해 완성된 아웃풋 벡터들은 마찬가지로 다른 attention head들로부터 나온 벡터들과 이어붙여진다. 한 가지 문제점은 이렇게 이어진 벡터들 간의 시퀀스의 위치에 대한 정보가 없다는 점이다. 시퀀스의 위치 정보를 반영하기 위해, 1) 위치별 유일한 벡터값을 가지며, 2) 서로 다른 길이의 시퀀스에도 문제없이 적용이 가능하고, 3) 서로 다른 길이의 시퀀스의 두 인덱스 간 거리가 일정한(출처 : https://hongl.tistory.com/231) positional encoding 기법을 적용한다.

Vision Transformer​

출처 : https://ai.googleblog.com/2020/12/transformers-for-image-recognition-at.html

출처 : https://ai.googleblog.com/2020/12/transformers-for-image-recognition-at.html

자연어 처리에서는 거의 Transformer를 쓰지 않는 태스크가 없을 정도로 Transformer는 무시무시한 성능을 자랑한다. Sequence 데이터에만 적용되던 Transformer는 이제 컴퓨터 비젼 영역까지 그 영향력을 확장했다. Vision Transformer의 방법은 기존 Transformer와 크게 다르지 않다. 똑같이 positional encoding을 붙이고, kqv 연산을 포함한 muli-headed attention, layer normalization, Residual 구조, 그리고 Feed-forward layer로 이루어져있다. 다만 다른 점은 3D로 구성된 이미지를 patch들로 찢어서 Sequence를 구성했다는 점과, decoder 부분을 제외하고, encoder만 활용했다는 점이다.

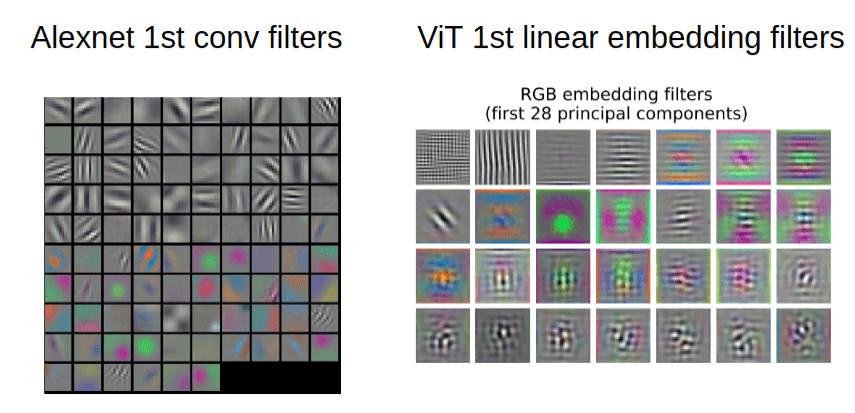
출처 : https://theaisummer.com/vision-transformer/ 좌측은 Alexnet 필터, 우측은 ViT 필터

출처 : https://theaisummer.com/vision-transformer/ 좌측은 Alexnet 필터, 우측은 ViT 필터

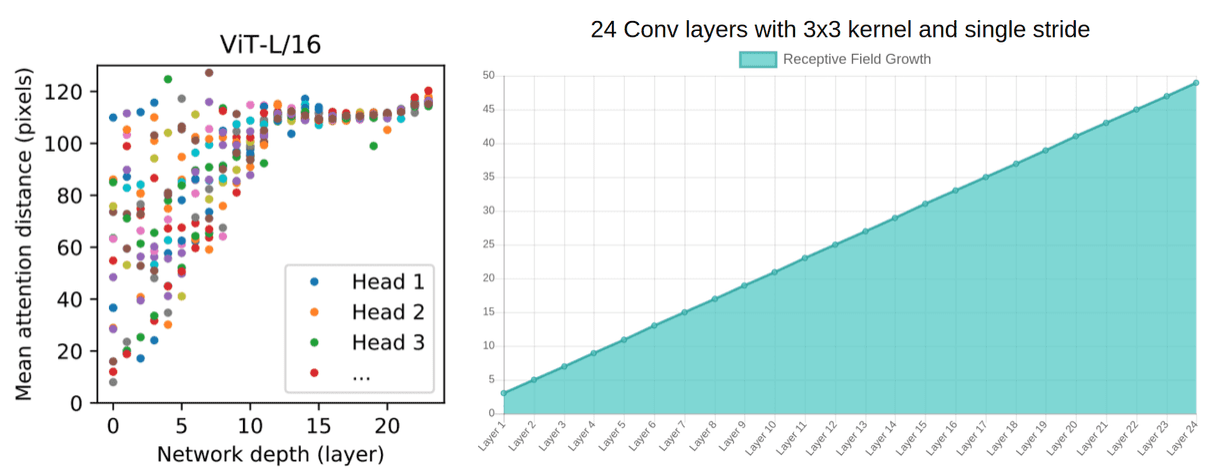
출처 : https://theaisummer.com/vision-transformer/ 좌측은 네트워크 깊이에 따른 ViT의 평균 Attention Distance . 우측은 Conv layer에 따른 receptive field의 성장

출처 : https://theaisummer.com/vision-transformer/ 좌측은 네트워크 깊이에 따른 ViT의 평균 Attention Distance . 우측은 Conv layer에 따른 receptive field의 성장

픽셀과 픽셀 사이의 지역적인 패턴들(receptive fields)을 뽑아내기 위해서 기존에는 convolutional layer를 겹겹히 쌓아야했다면, ViT의 경우, 첫번째 MHA(Multi-Headed Attention) 레이어부터 픽셀과 픽셀 간의 interaction을 확인할 수 있다.

마무리​

RNN부터 Attention까지, Transformer가 나오기 전, 시퀀스 데이터를 처리하기 위해 나온 모델들과 Transformer가 어떤 식으로 이미지 분야에 적용되는지 간략하게 살펴보았다. 전체적인 흐름을 이해하는데 본 글을 참고하고, 자세한 구조적인 설명은 논문들을 참고하면 좋을 것 같다.

Transformer (2)편에서는 지금 회사에서 내가 맡고 있는 OCR 업무 중 **텍스트 이미지 인식(Scene Text Recogntion)**에 활용된 Transformer 모델들에 대해서 알아보고, 모델 학습을 진행하려고 한다.

참조​